
이 포스팅은 Kaggle::Titanic 시리즈 10 편 중 4 번째 글 입니다.
목차
Kaggle에 있는 Titanic Prediction 문제의 데이터를 알아본다.
데이터 불러오기, 미리보기
# 우리는 데이터를 3단계로 나눠야 한다.
# 1. train data
# 2. test data(만든 모델을 test)
# 3. validation(최종 예측 용)
data_raw = pd.read_csv('../input/train.csv')
data_val  = pd.read_csv('../input/test.csv')

# 기본 데이터는 냅두고, 이걸 복사해서 쓰는 것이 효율적이다.
# 여기서 python이 기본적으로 reference로 shellow copy를 한다는 점을 인지하고 deep copy를 해야한다.

data1 = data_raw.copy(deep = True)

# copy by reference를 한다는 점을 이용하여, 빈번하게 수정할 데이터를 한번에 list로 갖고 있자.
data_cleaner = [data1, data_val]


#preview data
print (data_raw.info())
#data_raw.head()
#data_raw.tail()
data_raw.sample(10) # random으로 10개를 뽑아준다.
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 891 entries, 0 to 890
Data columns (total 12 columns):
PassengerId    891 non-null int64
Survived       891 non-null int64
Pclass         891 non-null int64
Name           891 non-null object
Sex            891 non-null object
Age            714 non-null float64
SibSp          891 non-null int64
Parch          891 non-null int64
Ticket         891 non-null object
Fare           891 non-null float64
Cabin          204 non-null object
Embarked       889 non-null object
dtypes: float64(2), int64(5), object(5)
memory usage: 83.6+ KB
None
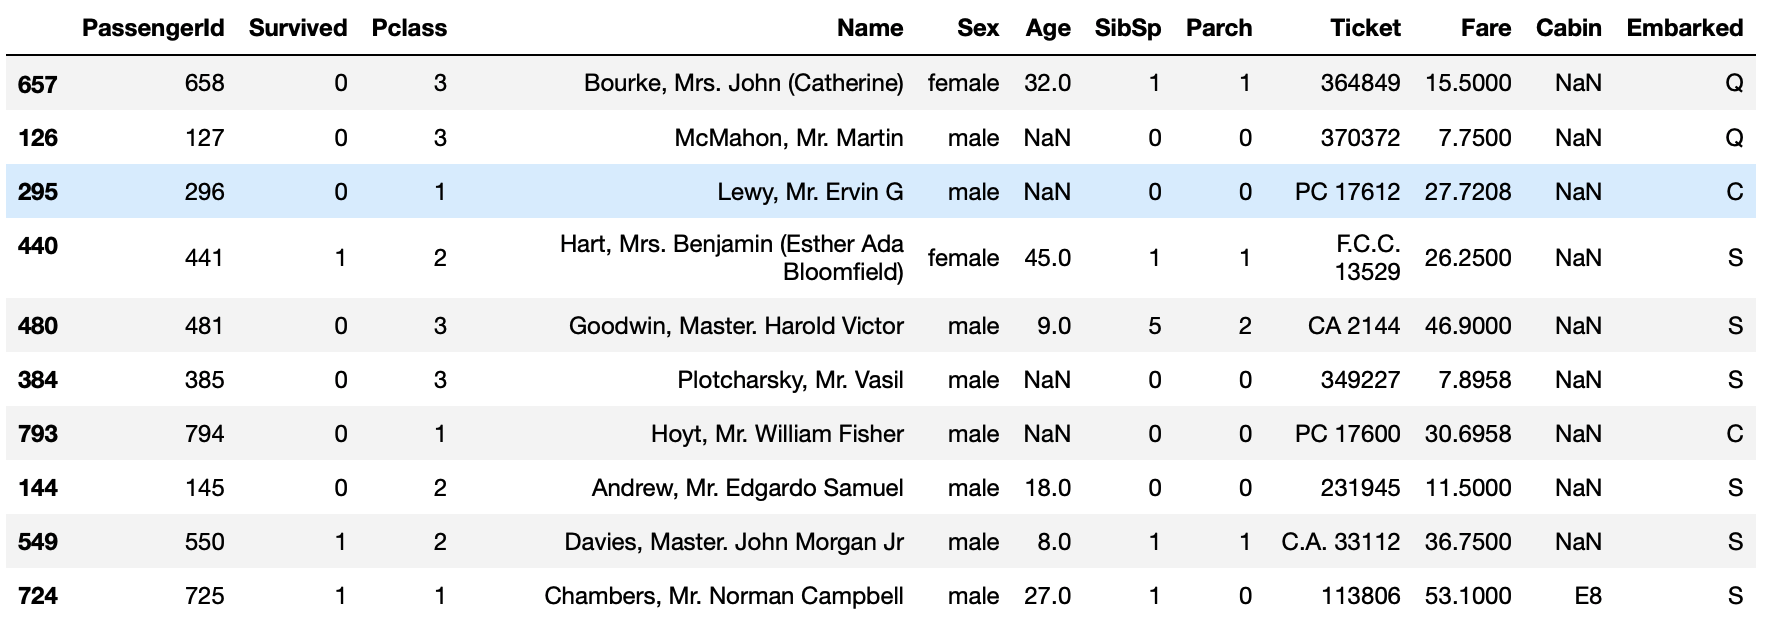
- Survived 변수는 종속 변수이다. 이진 데이터 타입이다. 다른 변수들은 종속 변수이다. 종속 변수들을 모두 사용한다고 좋은 결과가 나오는 것이 아니다. 올바른 변수를 사용해야 한다.
- PassengerID 와 Ticket 변수는 random한 식별자이다. 따라서 사용하더라도 유용하지 않으므로 배제한다.
- Pclass는 사회적 지위를 알 수 있는 지표이다. 1 = upper class, 2 = middle class, and 3 = lower class.
- Name은 string 데이터이다. 이 변수는 성별, 지위 등을 알 수 있을 수 있다. 하지만 이미 지위 변수가 있기 때문에, Master와 같은 title이 붙었을 때, 유의미한 차이가 있는 지 확인하기 위해서 사용한다.
- Sex 와 Embarked 변수는 string 데이터 이다. 이 부분을 사용하기 위해 dummy화를 진행한다.
- Age 와 Fare 실수형 데이터이다.
- SibSp 는 관련된 형제나 배우자의 수를 나타낸다.(siblings/spouse abroad) Parch 는 관련된 부모와 아이들의 수를 나타낸다. (parents/children aboard) 두 변수는 이산 데이터 타입이다. 이 변수를 가지고 가족의 크기나, 혼자인지를 판명하는 변수를 만들 수 있다.
- Cabin string 데이터 이다. 이 변수를 가지고 사고가 일어났을 때, 해당 사람의 배 안에서의 대략적인 위치를 알 수 있다. 하지만 결측치가 많기 때문에 분석에서는 제외한다.
| Variable | Definition | Key |
|---|---|---|
| survival | Survival | 0 = No, 1 = Yes |
| pclass | Ticket class | 1 = 1st, 2 = 2nd, 3 = 3rd |
| sex | Sex | |
| Age | Age in years | |
| sibsp | # of siblings / spouses aboard the Titanic | |
| parch | # of parents / children aboard the Titanic | |
| ticket | Ticket number | |
| fare | Passenger fare | |
| cabin | Cabin number | |
| embarked | Port of Embarkation | C = Cherbourg, Q = Queenstown, S = Southampton |